Извлечь таблицы (Tesseract)
Описание
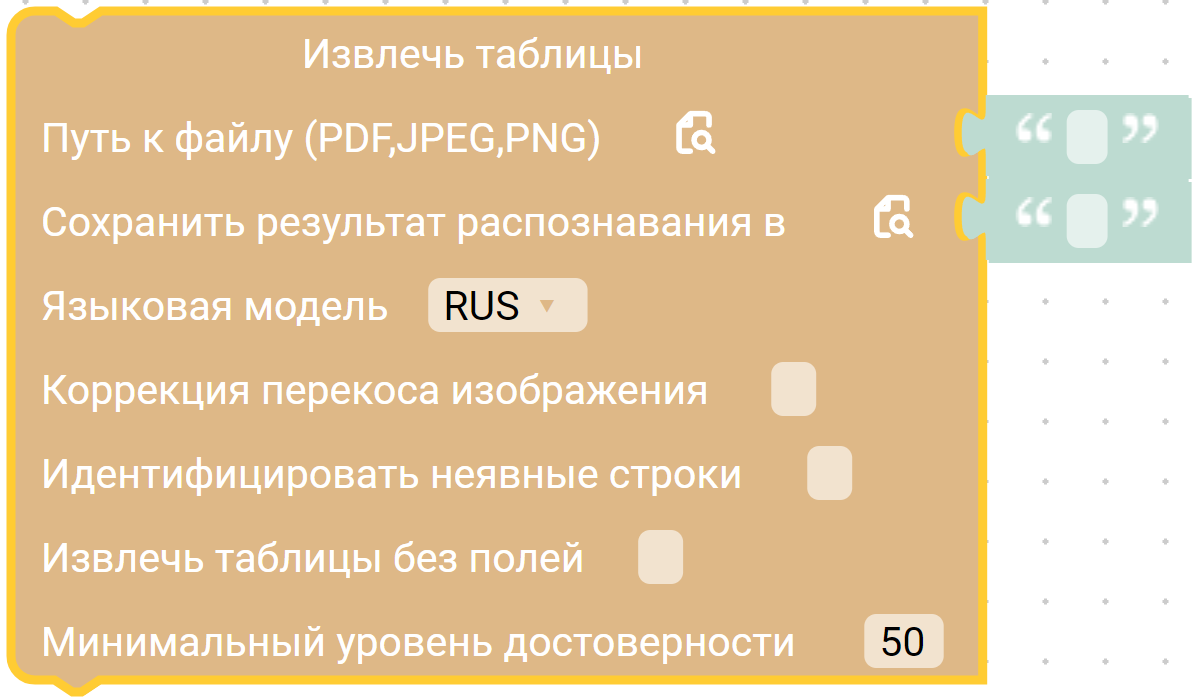
Блок извлекает таблицы из файла с помощью Tesseract OCR и сохраняет результат в Excel-файл. Каждая найденная таблица записывается на отдельный лист.
Описание параметров
-
Путь к файлу (PDF, JPEG, PNG) — путь к входному файлу с таблицами.
Тип данных:
str (Строка)Пример:
C:\\docs\\table.pdf -
Сохранить результат распознавания в — путь к итоговому Excel-файлу.
Тип данных:
str (Строка)Пример:
C:\\docs\\tables.xlsx -
Языковая модель — язык распознавания текста:
- RUS — русский язык;
- ENG — английский язык;
- RUS+ENG — одновременное распознавание русского и английского языков.
-
Коррекция перекоса изображения — автоматическое выравнивание изображения перед распознаванием.
Тип данных:
checkbox (Чекбокс)Пример:
Истина -
Идентифицировать неявные строки — попытка восстановить строки таблицы, даже если они слабо выражены визуально.
Тип данных:
checkbox (Чекбокс)Пример:
Ложь -
Извлечь таблицы без полей — поиск таблиц без явных границ ячеек.
Тип данных:
checkbox (Чекбокс)Пример:
Ложь -
Минимальный уровень достоверности — порог уверенности распознавания OCR (от
0до100).Тип данных:
int | float (Число)Пример:
50
Пример использования
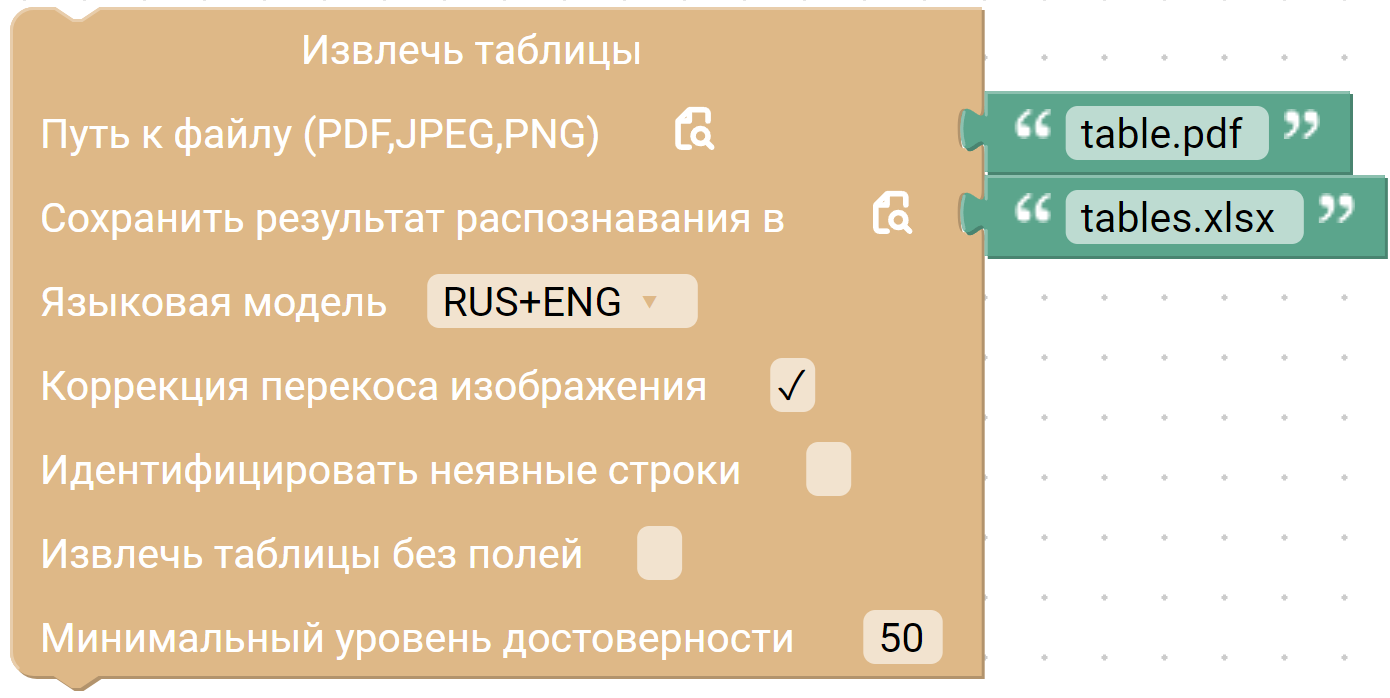
В данном примере блок извлекает таблицы из файла table.pdf с языковой моделью RUS+ENG,
включенной коррекцией перекоса и сохраняет результат в tables.xlsx.
Результат
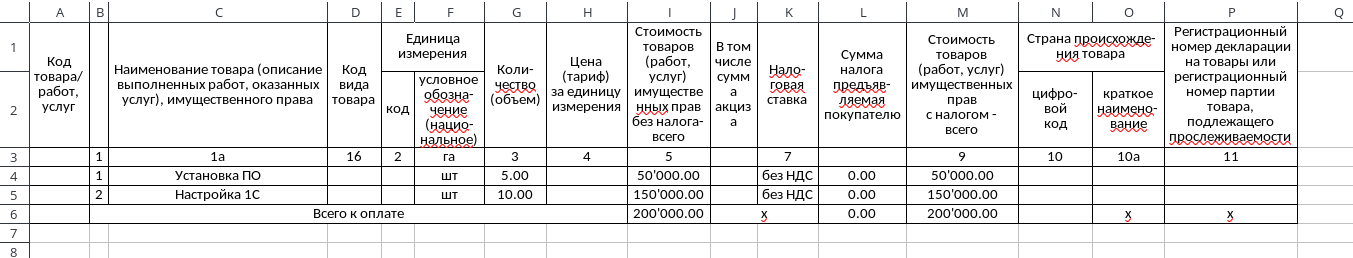
Сохраненная таблица в Excel-файле: