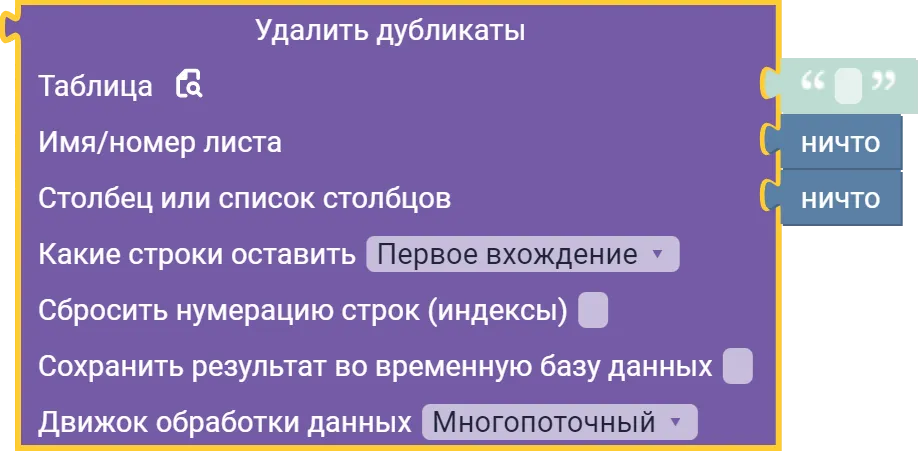
Удалить дубликаты
Описание
Блок удаляет повторяющиеся строки из табличных данных. Строки сравниваются либо по всем столбцам, либо только по указанным — тогда две строки считаются одинаковыми, если совпадают значения в перечисленных столбцах. Для каждой группы одинаковых строк можно оставить первое вхождение, последнее вхождение или удалить все одинаковые строки полностью.
Источником данных может быть DataFrame из переменной или путь к файлу (Excel, CSV, база данных).
Описание параметров
Блок имеет ряд параметров:
-
Таблица — DataFrame или путь к файлу с табличными данными;
Тип данных:
DataFrame | str (Строка)Пример:
table -
Имя/номер листа — лист книги Excel, из которого считываются данные (имя или порядковый номер, начиная с
0). Используется только при чтении из файла;Тип данных:
str (Строка) | int (Целое число)Пример:
0 -
Столбец или список столбцов — столбцы, по которым ищутся дубликаты. Если параметр не задан, строки сравниваются по всем столбцам;
Тип данных:
str (Строка) | list (Список)Пример:
["Email", "Телефон"] -
Какие строки оставить — что делать с группой одинаковых строк:
Тип данных:
dropdown (Выпадающий список)Пример:
Первое вхождение- Первое вхождение — остаётся первая из одинаковых строк;
- Последнее вхождение — остаётся последняя из одинаковых строк;
- Удалить все одинаковые строки — из таблицы удаляются все строки, у которых есть дубликат;
-
Сбросить нумерацию строк (индексы) — восстановить сквозную нумерацию строк
0, 1, 2, …в результате;Тип данных:
checkbox (Чекбокс)Пример:
✔ -
Сохранить результат во временную базу данных — сохранить результат в локальную базу данных проекта;
Тип данных:
checkbox (Чекбокс)Пример:
✔ -
Движок обработки данных — способ использования ресурсов процессора при обработке таблиц:
Тип данных:
dropdown (Выпадающий список)Пример:
Стандартный- Стандартный — обработка в одном потоке;
- Многопоточный — обработка с использованием нескольких потоков, подходит для больших таблиц.
Возвращаемое значение
DataFrame без повторяющихся строк.
Тип данных: DataFrame
Пример: unique_df
Пример использования
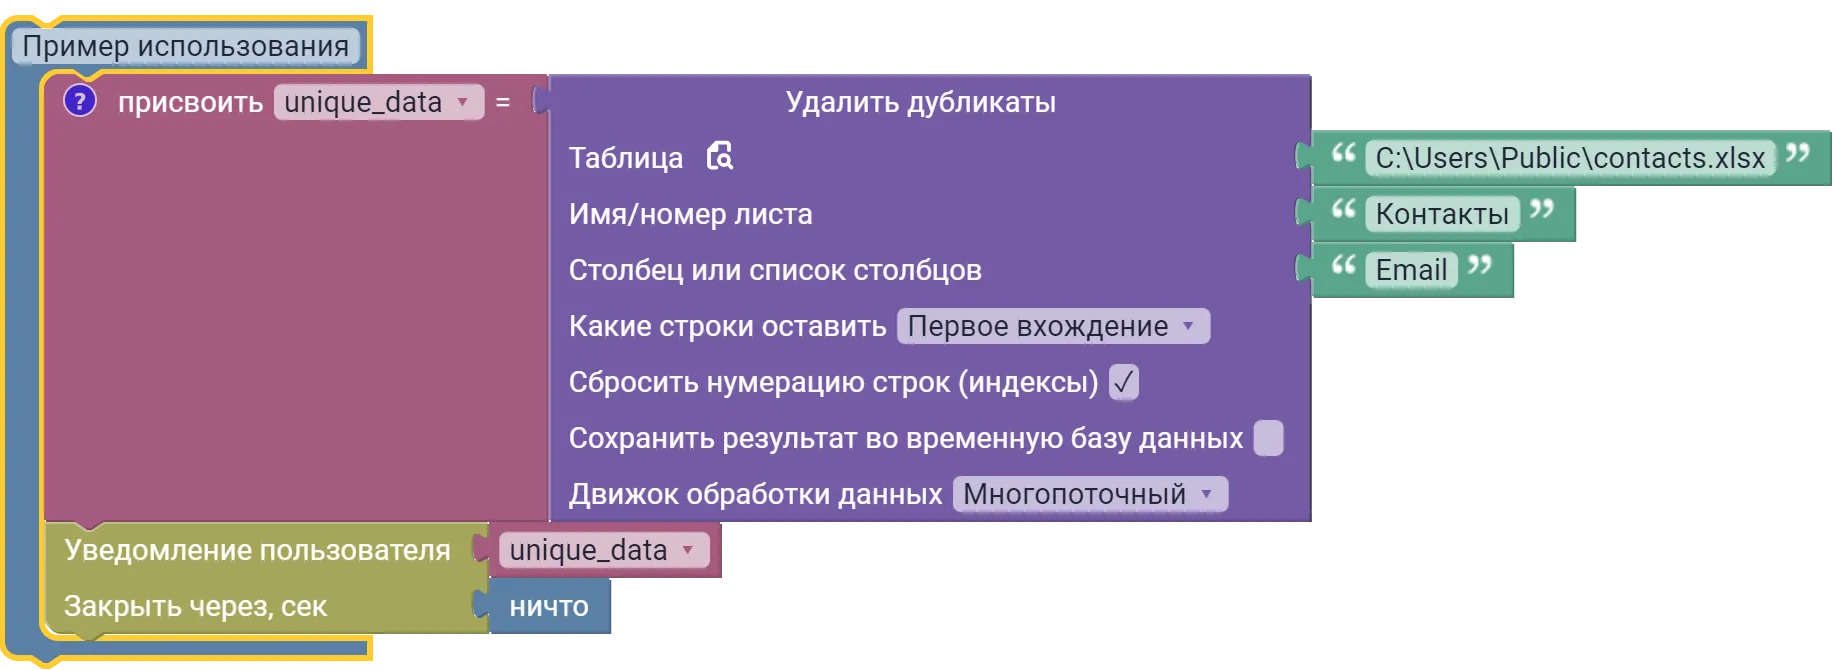
В данном примере из списка контактов, хранящегося в файле Excel, удаляются повторы по адресу электронной почты. Файл contacts.xlsx лежит в папке C:\Users\Public, лист Контакты содержит столбцы ФИО, Email, Телефон и Город; часть контактов встречается несколько раз с одним и тем же адресом почты, но с разным написанием имени или другим телефоном.
- В параметр Таблица блока Удалить дубликаты передаётся путь к файлу
C:\Users\Public\contacts.xlsx, в параметре Имя/номер листа указываетсяКонтакты; - В параметре Столбец или список столбцов указывается
Email— строки сравниваются только по этому столбцу; - В параметре Какие строки оставить выбирается Первое вхождение, флаг Сбросить нумерацию строк (индексы) включается;
- Результат сохраняется в переменную unique_df и показывается блоком Уведомление пользователя.
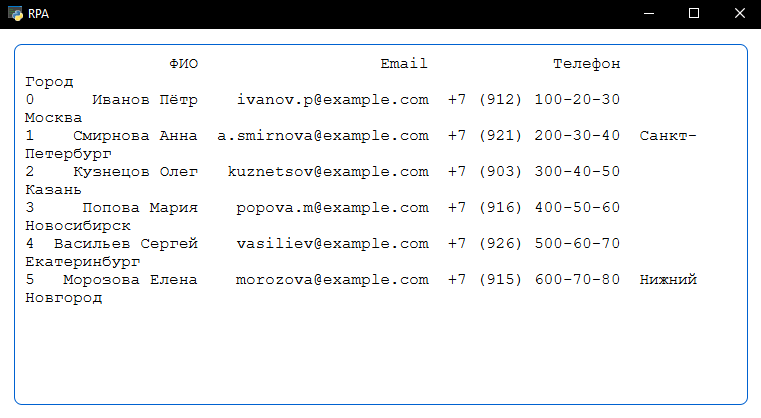
Результат
Уведомление с таблицей, в которой для каждого адреса электронной почты осталась только первая строка из исходного файла, а строки пронумерованы заново с 0: